Nie trzeba było włamywać się do Facebooka, kraść haseł ani wykorzystywać żadnego zero-daya. Wystarczyło stworzyć test osobowości, przekonać kilkaset tysięcy ludzi do zalogowania się przez Facebooka i wykorzystać możliwości, które sam serwis udostępniał wówczas aplikacjom. Około 270 tys. osób świadomie wzięło udział w badaniu, ale aplikacja mogła pobierać również informacje dotyczące ich facebookowych znajomych. Facebook oszacował później, że dane nawet 87 mln kont mogły zostać niewłaściwie przekazane Cambridge Analytica – firmie zajmującej się analizą danych wyborców i marketingiem politycznym. W Polsce quiz uruchomiły zaledwie 23 osoby. Potencjalnie dotkniętych zostało jednak 57 138 polskich użytkowników. Afera pokazała coś znacznie groźniejszego niż zwykły wyciek: w świecie social mediów czasem wystarczyło, że zgodę na dostęp do części Twoich danych wyraził… ktoś z Twoich znajomych.
To również historia, która przez lata została obudowana warstwą mitów. Cambridge Analytica rzeczywiście pracowała przy amerykańskich kampaniach wyborczych, w tym kampanii Donalda Trumpa w 2016 roku. Rzeczywiście interesowała się psychografią, mikrotargetowaniem i próbowała przypisywać wyborcom cechy osobowości. Nie ma natomiast podstaw, żeby z tego automatycznie wyciągać wniosek, że firma „zhakowała wybory”, „sterowała umysłami” albo samodzielnie zapewniła komukolwiek zwycięstwo. Największy skandal Cambridge Analytica nie polega na udowodnionej magicznej skuteczności jej modeli. Polega na tym, w jaki sposób dane milionów ludzi zostały pozyskane, przekazane i wykorzystane do profilowania bez ich bezpośredniej świadomości.
Cambridge Analytica nie była częścią Uniwersytetu Cambridge
Zacznijmy od podstawowego nieporozumienia. Cambridge Analytica nie była instytutem Uniwersytetu Cambridge. Była firmą konsultingową wywodzącą się z brytyjskiej grupy SCL, która od lat zajmowała się komunikacją strategiczną, analizą zachowań i kampaniami politycznymi. Cambridge Analytica została utworzona jako podmiot skoncentrowany przede wszystkim na rynku amerykańskim. Finansowo wspierała ją rodzina miliardera Roberta Mercera, a z przedsiębiorstwem związany był również Steve Bannon. Twarzą firmy stał się natomiast elegancki, niezwykle pewny siebie Alexander Nix.
Nazwa okazała się marketingowo doskonała. „Cambridge” kojarzyło się z nauką, statystyką i jednym z najlepszych uniwersytetów świata, a „Analytica” sugerowała chłodną, matematyczną analizę. Prawdziwe powiązanie z uczelnią pojawiło się gdzie indziej. Kluczową postacią całej historii był Aleksandr Kogan, psycholog i badacz pracujący na University of Cambridge, który prowadził jednocześnie firmę Global Science Research. To właśnie jego aplikacja stała się narzędziem pozwalającym zgromadzić ogromny zbiór danych z Facebooka.
Pomysł idealnie pasował do atmosfery pierwszej połowy poprzedniej dekady. Facebook posiadał już miliardy interakcji użytkowników: polubienia, zainteresowania, strony, znajomych, miejsca zamieszkania i dziesiątki innych sygnałów. Badacze wykazywali, że na podstawie takich cyfrowych śladów można z określonym prawdopodobieństwem przewidywać różne cechy człowieka. Cambridge Analytica zobaczyła w tym nie tylko ciekawostkę naukową, ale potencjalne narzędzie marketingowe.
Polubione strony jako test osobowości
Jednym z modeli psychologicznych znajdujących się w centrum zainteresowania był OCEAN, znany również jako Big Five. Opisuje osobowość za pomocą pięciu głównych wymiarów: otwartości na doświadczenia, sumienności, ekstrawersji, ugodowości i neurotyczności. Nie jest to wynalazek Cambridge Analytica. Model funkcjonował w psychologii od lat. Nowością było natomiast połączenie go z ogromną ilością danych pozostawianych przez ludzi w internecie.
Jeżeli tysiące osób jednocześnie wypełnią profesjonalny kwestionariusz osobowości i udostępnią historię swoich facebookowych „lajków”, można zacząć szukać korelacji. Być może ludzie o określonych zainteresowaniach częściej osiągają konkretny wynik w jednym z wymiarów osobowości. Jeśli model jest wystarczająco dobry, później nie trzeba już pytać kolejnego człowieka o jego charakter. Można spróbować przewidzieć go na podstawie zachowania.
Z perspektywy marketingu politycznego brzmi to niezwykle atrakcyjnie. Tradycyjna kampania wie, że wyborca ma 42 lata, mieszka na przedmieściach, ma określony dochód i głosował wcześniej na daną partię. Kampania psychograficzna chciałaby wiedzieć dodatkowo, czy jest lękliwy, impulsywny, konserwatywny w zachowaniu, otwarty na nowe doświadczenia albo wyjątkowo podatny na komunikaty związane z zagrożeniem. Następnie zamiast jednej reklamy dla miliona ludzi można przygotować dziesiątki wariantów tego samego przekazu.
Problemem było zdobycie danych pozwalających stworzyć takie profile na naprawdę dużą skalę.
Facebook dostarczył mechanizm, który niezwykle to ułatwiał.
„This Is Your Digital Life”. Niewinny test, który otworzył ogromną bazę
Aplikacja Kogana funkcjonowała pod nazwą „thisisyourdigitallife” i przedstawiała użytkownikowi test osobowości. Uczestnicy odpowiadali na pytania, logowali się przez Facebooka i otrzymywali niewielkie wynagrodzenie. Na tym etapie nie było jeszcze nic niezwykłego – internetowe badania psychologiczne wykorzystujące płatnych respondentów są czymś zupełnie normalnym.
Różnica polegała na możliwościach ówczesnej platformy Facebooka. Po autoryzowaniu aplikacji mogła ona otrzymać nie tylko informacje o człowieku, który właśnie zgodził się na udział w badaniu, lecz również określone informacje dotyczące jego znajomych, zależnie od ówczesnych ustawień prywatności i pól udostępnianych poprzez API. To właśnie tutaj pojawił się gigantyczny mnożnik.
FTC ustaliła później, że aplikacja zebrała dane od około 250–270 tys. osób, które bezpośrednio z niej skorzystały, a także informacje dotyczące dziesiątek milionów ich facebookowych znajomych. Użytkownikom aplikacji przekazywano przy tym zapewnienie, że nie będą pobierane ich nazwiska ani inne dane identyfikujące, podczas gdy aplikacja zbierała m.in. Facebook User ID umożliwiający powiązanie danych z konkretnym profilem.
I tutaj pojawia się najważniejszy element tej historii: większość ludzi znajdujących się później w zbiorze nigdy nie uruchomiła „This Is Your Digital Life”.
Nie zrobiła quizu. Nie przeczytała regulaminu. Nie otrzymała wynagrodzenia. Nie nacisnęła przycisku zgody dla tej aplikacji.
Wystarczyło, że zrobił to ich znajomy.
To nie był klasyczny „hack Facebooka”
Warto to podkreślić, ponieważ Cambridge Analytica do dzisiaj często jest przedstawiana jak klasyczne włamanie. Nie mamy tutaj historii podobnej do Yahoo, gdzie napastnicy sforsowali systemy przedsiębiorstwa i wykradli bazę kont. Nie skradziono 87 mln haseł. Nie wykorzystano tajnej luki umożliwiającej włamanie na cudze profile. Nie ma również podstaw, żeby twierdzić, że w ramach tej operacji Cambridge Analytica dostała prywatne wiadomości wszystkich poszkodowanych czy ich numery kart płatniczych.
Problem tkwił przede wszystkim w modelu działania samej platformy i późniejszym wykorzystaniu zdobytych informacji. Facebook w tamtym okresie celowo pozwalał aplikacjom na znacznie szerszy dostęp do danych społecznościowych niż kilka lat później. Firma chciała, aby Facebook był platformą, na której powstają gry, quizy i aplikacje korzystające z „social graphu”. Jeżeli aplikacja wiedziała, kim są Twoi znajomi, mogła pokazać Ci ich wyniki, zainteresowania czy zaprosić ich do wspólnej zabawy.
Dla producentów aplikacji było to świetne. Dla prywatności – znacznie mniej.
Facebook już w 2014 roku ogłosił poważne ograniczenie dostępu do informacji o znajomych poprzez nową wersję Graph API. Istniejące aplikacje otrzymały jednak okres przejściowy, dzięki czemu starsze narzędzia przez pewien czas mogły korzystać z szerszych uprawnień. Aplikacja Kogana należała właśnie do takich projektów. FTC później bardzo wyraźnie wskazywała, że ten mechanizm pozwolił zgromadzić dane osób, które same z aplikacją nie miały żadnego kontaktu.
Jak z 270 tysięcy zrobiło się 87 milionów?
To chyba najbardziej obrazowy przykład potęgi sieci społecznościowej. Załóżmy w dużym uproszczeniu, że jedną aplikację uruchamia człowiek posiadający 300 znajomych. Jeśli aplikacja może pobrać również część danych tych 300 osób, jedno kliknięcie otwiera potencjalnie setki dodatkowych profili. Oczywiście znajomi się powtarzają, nie każde konto udostępnia ten sam zakres informacji i rzeczywista matematyka jest znacznie bardziej skomplikowana. Przy setkach tysięcy uczestników skala i tak robi się jednak gigantyczna.
W pierwszych materiałach prasowych z marca 2018 roku mówiło się o około 50 mln profilach. Kilka tygodni później sam Facebook podał znacznie większą maksymalną liczbę: do 87 mln użytkowników, głównie w Stanach Zjednoczonych, których informacje mogły zostać niewłaściwie udostępnione Cambridge Analytica. Facebook zaznaczał jednocześnie, że był to szacunek wykonany szeroką metodą, ponieważ firma nie posiadała kompletnych historycznych logów pozwalających po latach dokładnie odtworzyć każde zapytanie aplikacji. Nie należy więc przedstawiać liczby 87 mln jako precyzyjnie policzonych rekordów wyciągniętych jednego dnia z jednej bazy. To maksymalny szacunek potencjalnie dotkniętych kont.
FTC w swoim późniejszym postępowaniu posługiwała się ostrożniejszymi liczbami dotyczącymi działania aplikacji: około 250–270 tys. bezpośrednich użytkowników i dane około 50–65 mln ich znajomych, w tym co najmniej 30 mln możliwych do zidentyfikowania konsumentów w USA. Różnica pomiędzy tymi liczbami nie oznacza, że któraś ze stron koniecznie „kłamała”. Wynika przede wszystkim z różnych metod liczenia i pytania, czy mówimy o danych, których pobranie potwierdzono w określonym zbiorze, czy o maksymalnej liczbie kont, których informacje mogły zostać udostępnione.
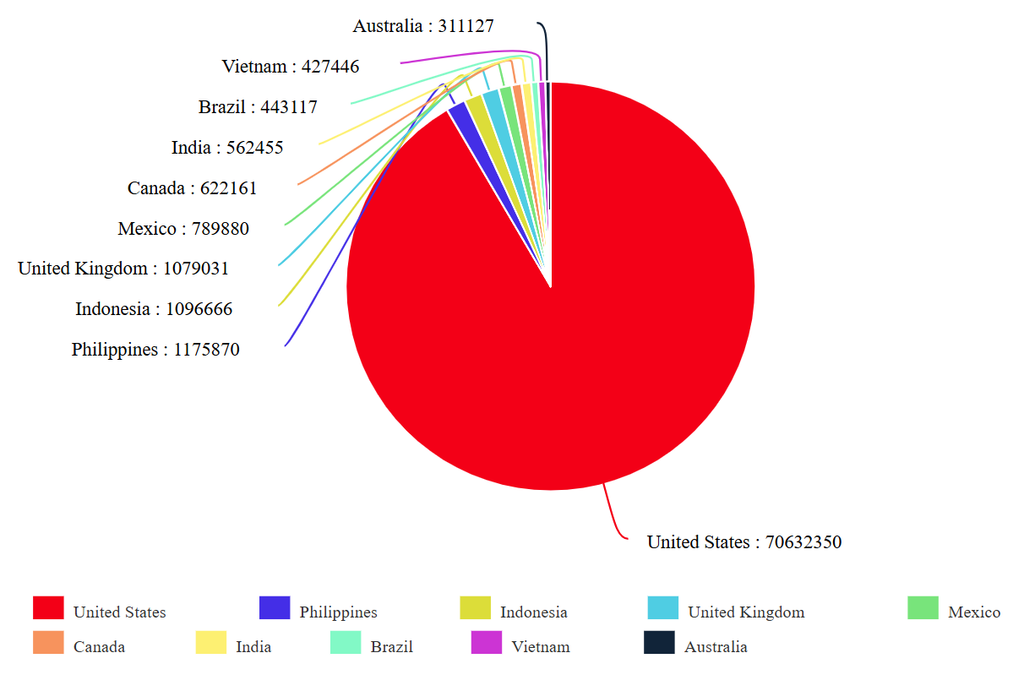
A Polska? Quiz zrobiły 23 osoby. Dotkniętych mogło być ponad 57 tysięcy
Jeżeli komuś liczba 87 mln wydaje się abstrakcyjna, polskie dane pokazują problem znacznie lepiej. Według informacji przekazanych w 2018 roku przez Facebooka „This Is Your Digital Life” zainstalowały zaledwie 23 osoby z Polski. Te dwadzieścia trzy instalacje wystarczyły jednak, aby w grupie potencjalnie dotkniętych znalazło się 57 138 użytkowników związanych z Polską. Pozostałe 57 115 osób znalazło się tam poprzez sieć znajomości użytkowników aplikacji.
To jest chyba najbardziej brutalne podsumowanie modelu prywatności Facebooka z tamtej epoki. Można było nigdy nie słyszeć o Koganie. Można było nie brać udziału w internetowych testach osobowości. Można było rozsądnie podchodzić do instalowanych aplikacji.
A jednak jeden z Twoich facebookowych znajomych mógł kliknąć quiz.
I to wystarczało, żeby informacje dotyczące również Twojego profilu znalazły się w procesie pozyskiwania danych.
Kogan zbierał dane. Cambridge Analytica chciała zrobić z nich profile wyborców
Global Science Research Kogana nawiązała współpracę z Cambridge Analytica i SCL. Dane z aplikacji były wykorzystywane do tworzenia modeli pozwalających przewidywać cechy osobowości na podstawie facebookowych zachowań. Następnie informacje te można było zestawiać z klasycznymi bazami wyborczymi, demografią oraz innymi komercyjnie dostępnymi zbiorami danych.
FTC opisała później mechanizm bardzo konkretnie: informacje pobrane poprzez aplikację służyły do trenowania algorytmu generującego oceny osobowości użytkowników i ich znajomych, a profile były następnie łączone z amerykańskimi danymi wyborczymi i wykorzystywane w usługach profilowania oraz targetowania reklam oferowanych przez Cambridge Analytica.
To warto odróżnić od często powtarzanego uproszczenia, że firma posiadała na każdego człowieka kompletną „kartotekę psychologiczną”. Model statystyczny nie czyta myśli. Produkuje przewidywanie z określonym prawdopodobieństwem. Może uznać, że dany człowiek prawdopodobnie jest bardziej neurotyczny albo mniej otwarty na doświadczenia. Czasem trafi, czasem nie. Na poziomie milionów odbiorców nawet umiarkowanie skuteczna segmentacja może być jednak wartościowa dla reklamodawcy.
W polityce nie musisz przekonać wszystkich
Tradycyjna reklama polityczna jest stosunkowo widoczna. Kandydat kupuje spot telewizyjny i miliony ludzi oglądają tę samą wersję. Dziennikarze mogą ją zobaczyć, konkurenci mogą odpowiedzieć, a społeczeństwo mniej więcej wie, jaki komunikat dana kampania kieruje do wyborców.
Reklamy internetowe pozwalają działać znacznie precyzyjniej. Jedna grupa może dostać komunikat o gospodarce, druga o przestępczości, trzecia o podatkach, a czwarta materiał mający przede wszystkim zniechęcić ją do konkurenta. Dwie osoby mieszkające obok siebie mogą przez całą kampanię widzieć zupełnie inną wersję politycznej rzeczywistości.
Jeśli dodamy do tego dane behawioralne i model osobowości, powstaje idea psychograficznego mikrotargetowania. Nie pokazujesz reklamy wyłącznie „kobietom 35–45 z Ohio”. Próbujesz pokazać konkretny wariant komunikatu ludziom, których model uważa na przykład za bardziej podatnych na przekazy odwołujące się do zagrożenia albo bezpieczeństwa.
Cambridge Analytica bardzo chętnie przedstawiała swoją technologię właśnie jako tego rodzaju przewagę. Pytanie brzmi jednak, czy była ona naprawdę tak rewolucyjna, jak firma twierdziła.
Ted Cruz, później Donald Trump
Cambridge Analytica pracowała podczas republikańskich prawyborów dla kampanii Teda Cruza, a następnie w 2016 roku została zaangażowana przez kampanię Donalda Trumpa. Firma świadczyła usługi analityczne, cyfrowe i związane z targetowaniem wyborców. Ten fakt nie jest przedmiotem sporu. Znacznie bardziej skomplikowana jest odpowiedź na pytanie, w jakim dokładnie zakresie podczas kampanii Trumpa wykorzystano słynne profile psychograficzne zbudowane dzięki danym Facebooka.
Sam Alexander Nix mówił przed brytyjskim parlamentem, że w przypadku kampanii Trumpa firma skoncentrowała się przede wszystkim na analizie danych, technologii, reklamie cyfrowej i targetowaniu telewizyjnym, natomiast nie zdążyła wdrożyć psychograficznego podejścia w takim zakresie, w jakim stosowała je wcześniej przy kampanii Cruza. Jednocześnie FTC później potwierdziła, że dane z aplikacji Kogana były używane przez Cambridge Analytica do budowania ocen osobowości i łączenia ich z rejestrami wyborców. Najuczciwsze podsumowanie brzmi więc: Cambridge Analytica rzeczywiście posiadała i rozwijała psychograficzne modele wyborców, ale dokładny udział tych konkretnych modeli w kampanii Trumpa pozostaje znacznie mniej jednoznaczny niż sugerują popularne opowieści o „psychologicznym sterowaniu wyborami”.
I przede wszystkim nie istnieje wiarygodny sposób udowodnienia, że Cambridge Analytica „wygrała Trumpowi wybory”. Wybory prezydenckie w USA w 2016 roku miały dziesiątki czynników politycznych, społecznych i ekonomicznych, a sam fakt wykorzystania danych i targetowania reklam nie pozwala przypisać firmie określonej liczby zmienionych głosów. Można oceniać legalność i etykę sposobu pozyskania danych bez tworzenia wokół Cambridge Analytica mitu o technologii potrafiącej dowolnie sterować wyborcami.
A Brexit? Tutaj trzeba szczególnie uważać na skróty
Jeszcze więcej chaosu narosło wokół referendum w sprawie wyjścia Wielkiej Brytanii z Unii Europejskiej. Cambridge Analytica prowadziła rozmowy i działania przygotowawcze związane z Leave.EU, a przedstawiciele obu stron w różnych momentach publicznie wypowiadali się o wzajemnych kontaktach. Nie oznacza to jednak, że można odpowiedzialnie napisać: „Cambridge Analytica przeprowadziła zwycięską kampanię Brexit”.
Leave.EU nie było ostatecznie oficjalnie wyznaczoną główną kampanią referendalną po stronie Leave – tę rolę otrzymało Vote Leave. Brytyjska Electoral Commission stwierdziła, że pomiędzy Cambridge Analytica i Leave.EU istniała relacja na etapie przygotowań, ale nie znaleziono podpisanej umowy, płatności ani dowodów, że porady Cambridge Analytica zostały wykorzystane przez Leave.EU podczas właściwego regulowanego okresu kampanii referendalnej. Jednocześnie parlamentarne dochodzenia ujawniały rozbudowane kontakty i propozycje współpracy. Dlatego także tutaj sensacyjny skrót „Cambridge Analytica zrobiła Brexit” idzie dalej niż ustalone fakty.
To rozróżnienie jest ważne również dlatego, że prawdziwa historia jest wystarczająco mocna bez jej doprawiania. Firma zajmująca się profilowaniem wyborców prowadziła kontakty z wielkimi kampaniami politycznymi, posiadała ogromne zbiory danych pochodzących z Facebooka i rozwijała metody indywidualnego targetowania. Nie trzeba przypisywać jej nadnaturalnej zdolności zmieniania wyników wyborów, żeby uznać problem za poważny.
Facebook dowiedział się o problemie już w 2015 roku
To właśnie ten element sprawił, że trzy lata później kryzys uderzył nie tylko w Cambridge Analytica, ale również w Facebooka. W grudniu 2015 roku „The Guardian” opisał wykorzystanie facebookowych danych w związku z kampanią Teda Cruza. Facebook ustalił, że Kogan przekazał informacje zebrane przez aplikację podmiotom zewnętrznym, naruszając zasady platformy.
Serwis zażądał wtedy usunięcia danych. Kogan, Cambridge Analytica oraz inne osoby miały potwierdzić ich skasowanie. Facebook na tym etapie nie poinformował jednak dziesiątek milionów użytkowników, że ich informacje mogły wcześniej trafić poza platformę, ani nie przeprowadził skutecznej niezależnej weryfikacji pozwalającej mieć pewność, że wszystkie kopie rzeczywiście zniknęły. Brytyjski ICO później wskazywał wprost, że Cambridge Analytica nie usunęła wszystkich facebookowych danych w odpowiednim czasie pomimo wcześniejszych zapewnień.
I to właśnie stawia Facebooka w centrum afery. Problemem nie był wyłącznie jeden zewnętrzny deweloper, który wykorzystał możliwości API. Facebook zbudował architekturę pozwalającą aplikacjom sięgać szeroko do social graphu, a gdy dowiedział się o niewłaściwym przekazaniu danych, przez lata nie poinformował o tym wszystkich potencjalnie poszkodowanych.
Dlaczego więc świat dowiedział się o wszystkim dopiero w 2018 roku?
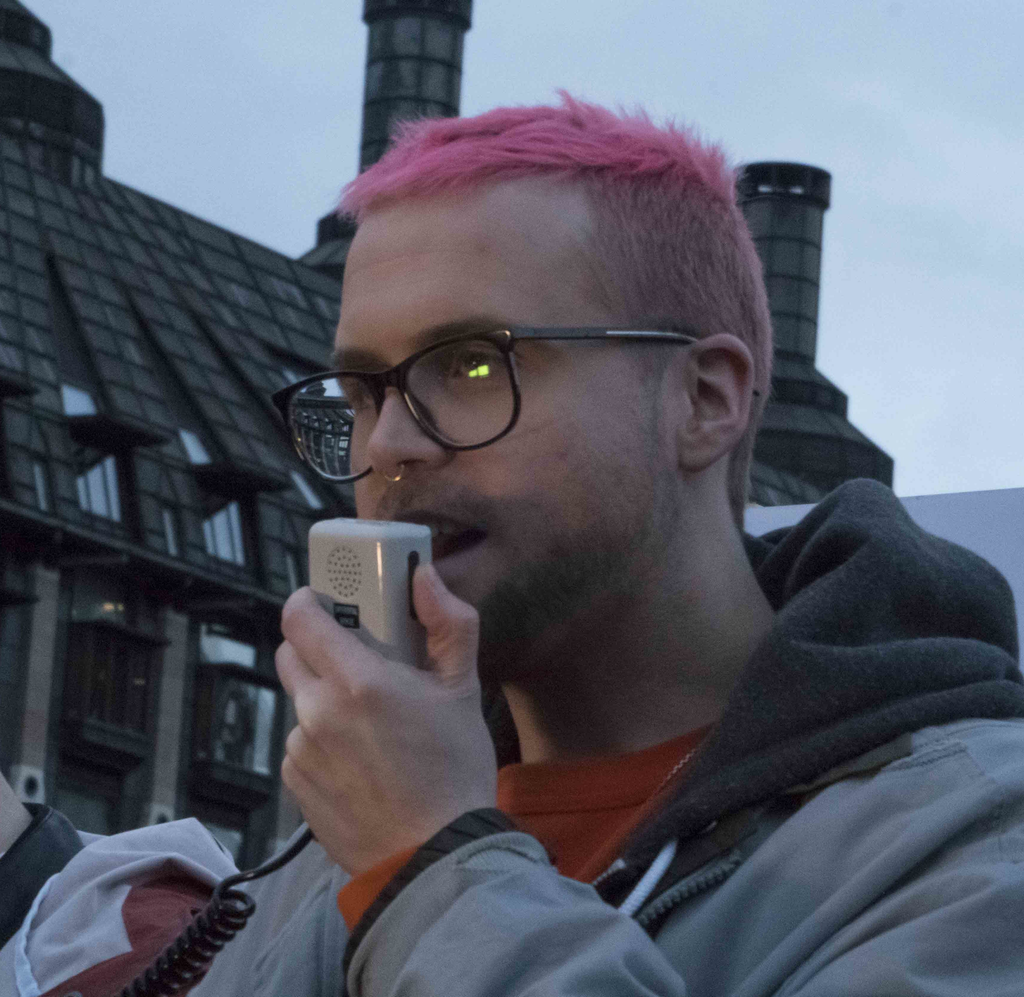
Kluczową postacią został Christopher Wylie, były pracownik Cambridge Analytica. Nie był zewnętrznym badaczem, który przypadkiem odkrył aferę. Sam uczestniczył wcześniej w rozwijaniu projektu i współpracował przy tworzeniu systemu, a dopiero później stał się sygnalistą. To ważna różnica, bo dzięki temu dysponował nie tylko własnymi podejrzeniami, ale dokumentami oraz wiedzą o tym, jak firma działała od środka.
17 marca 2018 roku „The Observer/The Guardian” i „The New York Times” opublikowały materiały ujawniające ogromną skalę pozyskania informacji z Facebooka. Początkowo media mówiły o około 50 mln profilach. Wylie publicznie opowiedział o mechanizmie zbierania danych, budowaniu modeli i współpracy z Cambridge Analytica. Kilka tygodni później Facebook podwyższył własny maksymalny szacunek liczby potencjalnie dotkniętych użytkowników do 87 mln.
Nagle temat, który trzy lata wcześniej pozostał branżową historią dotyczącą danych wyborczych, stał się globalnym skandalem dotyczącym prywatności.
Facebook najpierw kłócił się nawet o słowo „wyciek”
Pierwszą linią obrony Facebooka było zwracanie uwagi, że technicznie nie doszło do klasycznego data breach. Systemów firmy nie sforsowano, a Kogan uzyskał dane przy użyciu oficjalnego API po zgodzie użytkowników aplikacji. Z czysto technicznego punktu widzenia jest w tym sporo prawdy.
Dla człowieka, którego informacje zostały pobrane wyłącznie dlatego, że jego znajomy zrobił test osobowości, była to jednak dość akademicka różnica. Użytkownik nie musiał wiedzieć, że kilka lat wcześniej regulamin Facebooka pozwalał aplikacji znajomego otrzymywać dane również o nim. Tym bardziej nie musiał oczekiwać, że informacje trafią później do firmy zajmującej się profilowaniem wyborców.
Dlatego określenie „wyciek danych Cambridge Analytica” utrwaliło się w języku potocznym, choć dokładniejszym opisem jest „niewłaściwe pozyskanie i przekazanie danych poprzez platformę Facebooka”. Dla StopScam i kategorii „Wycieki danych” sprawa mimo wszystko pasuje idealnie – informacje wydostały się z kontekstu, w którym użytkownicy spodziewali się ich przetwarzania, i trafiły do podmiotu, któremu ogromna większość zainteresowanych nigdy bezpośrednio ich nie przekazała.
Potem pojawiły się nagrania z ukrytej kamery
Jakby sam skandal z Facebookiem nie wystarczał, Channel 4 przeprowadził śledztwo z ukrytą kamerą. Dziennikarze podawali się za potencjalnych klientów zainteresowanych kampanią polityczną. Alexander Nix podczas rozmów opowiadał o metodach, które można byłoby stosować wobec przeciwników – przewijały się między innymi scenariusze prowokacji, łapówek i wykorzystania kobiet do kompromitowania polityków.
Nagrania wywołały potężną burzę, ale również tutaj potrzebne jest rozróżnienie pomiędzy wypowiedzią a udowodnionym działaniem. Po ujawnieniu materiałów Nix został zawieszony przez Cambridge Analytica. Później przed brytyjskim parlamentem twierdził, że podczas rozmowy przesadzał i opowiadał rzeczy, których firma w rzeczywistości nie robiła, próbując zaimponować potencjalnemu klientowi. Wprost określił własne słowa jako głupie i twierdził, że wzmianka o „ukraińskich dziewczynach” była kłamstwem wypowiedzianym dla efektu. Nie zmienia to faktu, że słowa padły i zostały nagrane, ale nie należy automatycznie zamieniać handlowych przechwałek Nixa w dowód, że każda opisywana przez niego operacja rzeczywiście została wcześniej przeprowadzona.
Wizerunkowo było już jednak po wszystkim. Firma sprzedająca politykom zdolność do kształtowania zachowania wyborców została właśnie pokazana światu w materiale, w którym jej CEO opowiadał fałszywemu klientowi o możliwościach dyskredytowania przeciwników.
Zuckerberg trafia przed Kongres
Kryzys szybko przestał być problemem niewielkiej firmy konsultingowej z Londynu. Pytanie brzmiało: jak Facebook mógł zbudować system, w którym aplikacja używana przez kilkaset tysięcy ludzi otrzymuje informacje dotyczące dziesiątek milionów kolejnych osób?
10 i 11 kwietnia 2018 roku Mark Zuckerberg przez wiele godzin odpowiadał na pytania amerykańskich senatorów i członków Izby Reprezentantów. Dla Facebooka był to jeden z najważniejszych momentów w historii firmy. Serwis, który przez lata przedstawiał otwartość i swobodne udostępnianie informacji jako swoją największą zaletę, musiał tłumaczyć się z tego, dlaczego owa otwartość stworzyła system pozwalający podmiotom zewnętrznym gromadzić ogromne zbiory danych o ludziach, którzy nigdy z tymi podmiotami nie mieli kontaktu. Facebook rozpoczął też bezpośrednie powiadamianie użytkowników, których informacje mogły zostać udostępnione Cambridge Analytica.
Skandal przyczynił się do gwałtownej zmiany sposobu dyskusji o platformach społecznościowych. Jeszcze kilka lat wcześniej pytanie brzmiało przede wszystkim: „co użytkownik sam opublikował?”. Cambridge Analytica pokazała, że równie istotne jest pytanie: co platforma potrafi wywnioskować z zachowania użytkownika i komu pozwala te informacje pobierać?
Wyciekły nie tylko dane. Wyciekła możliwość przewidywania
To jeden z najbardziej niedocenianych elementów afery. Gdy wycieka baza sklepu internetowego, łatwo opisać zakres szkody: nazwisko, adres, telefon, e-mail, hash hasła. Cambridge Analytica pokazała inny rodzaj zagrożenia – dane pochodne, czyli informacje, których użytkownik nigdy bezpośrednio nie podał.
Nikt nie musiał zaznaczać na Facebooku pola „jestem neurotyczny: 74/100”. Wystarczyło odpowiednio dużo cyfrowych śladów i model statystyczny próbujący taką cechę oszacować. To samo dotyczy zainteresowań politycznych, podatności na określone komunikaty czy prawdopodobieństwa poparcia konkretnego kandydata.
Z punktu widzenia prywatności to niezwykle ważne. Człowiek może uznać, że polubienie dziesięciu zespołów muzycznych, trzech filmów, dwóch gazet i strony lokalnego klubu piłkarskiego nie mówi o nim nic szczególnie intymnego. Pojedynczo faktycznie może nie mówić wiele. Dopiero połączenie setek drobnych sygnałów tworzy profil, którego użytkownik nigdy świadomie nie napisał.
Współczesny problem prywatności nie polega więc wyłącznie na pytaniu „jakie dane podałem?”. Równie ważne staje się: „co ktoś może z nich wywnioskować?”.
Czy Cambridge Analytica naprawdę potrafiła „czytać ludzi”?
Prawdopodobnie w znacznie mniejszym stopniu, niż wynikało z marketingu firmy i późniejszych sensacyjnych nagłówków. Metody psychometryczne pozwalają znajdować statystyczne zależności pomiędzy cyfrowym zachowaniem i pewnymi cechami, ale nie zamieniają komputera w urządzenie do czytania myśli. Człowiek sklasyfikowany jako „wysoko neurotyczny” może zachować się zupełnie inaczej niż przewiduje model, a trafność zależy od jakości danych, grupy badanej, kontekstu i sposobu budowy algorytmu.
Cambridge Analytica miała przy tym ogromny interes biznesowy w przedstawianiu swoich możliwości jako wyjątkowych. Firma sprzedawała kampaniom politycznym przewagę nad konkurencją. Hasło „mamy dane podobne do tych, które mają inni specjaliści od reklamy internetowej” nie brzmi szczególnie atrakcyjnie. „Potrafimy zrozumieć psychikę każdego wyborcy i wysłać mu komunikat, który zmieni jego zachowanie” brzmi znacznie lepiej.
Paradoks polega na tym, że nawet jeśli marketing Cambridge Analytica mocno przesadzał, skandal dotyczący danych nadal pozostaje ogromny. Nie trzeba udowodnić skuteczności manipulacji, żeby ocenić sposób zdobycia informacji. Gdy ktoś zabierze dokumentację medyczną z gabinetu, nie pytamy najpierw, czy potrafił ją skutecznie wykorzystać. Sam nieuprawniony dostęp i dalsze używanie danych jest problemem.
Facebook zapłacił w Wielkiej Brytanii maksymalną wtedy karę
Brytyjski Information Commissioner’s Office przeprowadził szerokie dochodzenie dotyczące wykorzystywania danych w kampaniach politycznych. W październiku 2018 roku na Facebooka nałożono 500 tys. funtów kary za naruszenia związane z ochroną danych użytkowników. Kwota wygląda dziś niemal komicznie w zestawieniu z wielkością Facebooka, ale był to maksymalny poziom kary dostępny na podstawie obowiązującego w czasie naruszeń brytyjskiego Data Protection Act 1998. ICO wprost wskazywał, że pod nowszym reżimem prawnym potencjalna kara mogłaby być znacznie wyższa.
To ważny szczegół historyczny, ponieważ RODO zaczęło być stosowane dopiero 25 maja 2018 roku, już po wydarzeniach będących sednem Cambridge Analytica. Skandal wybuchł więc dokładnie w momencie, gdy Europa przechodziła z systemu stosunkowo niewielkich sankcji do modelu pozwalającego karać największe przedsiębiorstwa procentem ich globalnych obrotów.
Cambridge Analytica stała się tym samym jednym z najlepszych przykładów tłumaczących zwykłemu użytkownikowi, dlaczego ochrona danych osobowych przestała być niszową dziedziną interesującą wyłącznie prawników i administratorów.
A słynne 5 miliardów dolarów dla Facebooka? Tak, ale nie tylko za Cambridge Analytica
W 2019 roku amerykańska Federal Trade Commission zawarła z Facebookiem rekordową ugodę obejmującą 5 miliardów dolarów kary oraz nowe ograniczenia i obowiązki dotyczące prywatności. Cambridge Analytica była bardzo ważnym elementem kryzysu prowadzącego do dochodzenia, ale błędem byłoby napisać po prostu: „Facebook dostał 5 mld dolarów kary za Cambridge Analytica”.
Postępowanie FTC było szersze. Dotyczyło między innymi naruszania wcześniejszego nakazu FTC z 2012 roku, sposobu przedstawiania użytkownikom kontroli nad prywatnością i udostępniania informacji aplikacjom osób trzecich. Cambridge Analytica była jednym z najgłośniejszych przykładów pokazujących konsekwencje tych praktyk, ale pięciomiliardowa kara obejmowała szerszy katalog problemów z ochroną prywatności Facebooka.
W oddzielnym postępowaniu FTC uznała natomiast, że Cambridge Analytica stosowała wprowadzające w błąd praktyki przy pozyskiwaniu informacji o użytkownikach Facebooka. Alexander Nix i Aleksandr Kogan zawarli ugody z FTC, które między innymi zabraniały im składania fałszywych oświadczeń dotyczących pozyskiwania i wykorzystywania danych oraz nakazywały usunięcie informacji pozyskanych przez aplikację i powiązanych z nimi rezultatów pracy.
Cambridge Analytica nie przeżyła afery nawet dwóch miesięcy
Skandal eksplodował w połowie marca 2018 roku. Już na początku maja Cambridge Analytica i część powiązanych z nią podmiotów poinformowały o zakończeniu działalności i rozpoczęciu procedur upadłościowych. Firma przekonywała, że utraciła klientów wskutek gigantycznej fali negatywnej publikacji i nie jest już w stanie prowadzić rentownego biznesu.
Był to niesamowicie szybki koniec marki, która chwilę wcześniej przedstawiała się jako jedna z najbardziej zaawansowanych firm zajmujących się analizą wyborców na świecie. W ciągu kilku tygodni Cambridge Analytica przeszła drogę od tajemniczego przedsiębiorstwa dysponującego rzekomo potężną technologią psychologiczną do synonimu skandalu dotyczącego prywatności.
Alexander Nix poniósł również osobiste konsekwencje zawodowe. W 2020 roku zobowiązał się w Wielkiej Brytanii do sześcioletniego zakazu pełnienia funkcji dyrektora spółki, obowiązującego od 5 października 2020 do 4 października 2026 roku. Co ciekawe z dzisiejszej perspektywy, okres ten zakończył się dosłownie kilka dni temu.
Facebook zmienił zasady. Ale zrobił to dopiero wtedy, gdy model zaczął wyglądać niebezpiecznie
Trzeba przyznać Facebookowi jedno: problem szerokiego dostępu aplikacji do danych znajomych zaczął ograniczać jeszcze przed wybuchem afery. W 2014 roku firma zapowiedziała przejście na nowy model API, który znacznie ograniczał możliwość pobierania danych dotyczących znajomych użytkownika. Po Cambridge Analytica restrykcje poszły jednak znacznie dalej. Facebook ograniczył kolejne API, rozpoczął przeglądy aplikacji posiadających wcześniej szeroki dostęp i zaczął informować użytkowników o przypadkach wykrytego nadużycia danych.
To pokazuje ciekawy paradoks rozwoju internetu. Funkcja, która początkowo wygląda jak genialne ułatwienie dla deweloperów, może kilka lat później okazać się potężnym problemem bezpieczeństwa. W początkowym okresie Facebook chciał, żeby aplikacje były maksymalnie „społecznościowe”. Dostęp do listy znajomych i ich zainteresowań powodował, że gry i serwisy rozwijały się wirusowo. Im łatwiej aplikacja mogła połączyć użytkownika z jego siecią społeczną, tym bardziej atrakcyjna stawała się platforma.
Cambridge Analytica pokazała drugą stronę tego samego mechanizmu. Social graph jest bazą danych o relacjach pomiędzy ludźmi. Jeśli pozwolisz zewnętrznej aplikacji swobodnie po nim chodzić, prędzej czy później ktoś wykorzysta tę możliwość do czegoś więcej niż zapraszania znajomych do FarmVille.
Największą ofiarą była idea, że „przecież nie mam nic do ukrycia”
Cambridge Analytica świetnie pokazuje, dlaczego argument „nie mam nic do ukrycia” jest zbyt prosty. Dane nie muszą ujawniać przestępstwa, romansu ani kompromitującej fotografii, żeby posiadały wartość. Mogą po prostu umożliwiać lepsze przewidywanie zachowania człowieka.
Jeżeli reklamodawca wie, że dana grupa wyjątkowo silnie reaguje na lęk przed utratą pracy, może pokazywać jej reklamy budowane wokół zagrożenia ekonomicznego. Innej grupie można pokazać ten sam produkt jako symbol statusu, a jeszcze innej jako wybór ekologiczny. Produkt się nie zmienia. Zmienia się psychologiczny przycisk, który reklama próbuje nacisnąć.
Polityka wykorzystuje dokładnie te same narzędzia reklamowe co sprzedaż butów, samochodów czy kredytów. Różnica polega na konsekwencjach. Kiedy algorytm przekona człowieka do kupienia innego modelu telefonu, rezultat dotyczy głównie jego portfela. Kiedy te same mechanizmy są wykorzystywane do komunikacji wyborczej, pojawiają się pytania dotyczące przejrzystości kampanii, równości dostępu do informacji i tego, czy wyborcy powinni wiedzieć, dlaczego akurat oni zobaczyli konkretny przekaz.
Najważniejszy mit: Cambridge Analytica nie udowodniła, że potrafi „programować wyborców”
Po latach jest to chyba najważniejszy element wymagający uporządkowania. Cambridge Analytica stała się częścią popkultury. Powstały dokumenty, książki i setki materiałów sugerujących niemal dystopijny obraz firmy, która posiadała psychologiczny profil każdego Amerykanina i potrafiła za pomocą odpowiedniego bannera zmienić jego decyzję wyborczą.
Nie mamy dowodu na działanie takiego mechanizmu z taką skutecznością.
Firma prowadziła analizę danych. Budowała modele. Pracowała dla kampanii politycznych. Uzyskała dane Facebooka poprzez projekt Kogana. FTC potwierdziła wykorzystanie tych danych do tworzenia ocen osobowości i dopasowywania ich do rejestrów wyborczych. To są fakty. Nie wynika z nich jednak matematyczny dowód, że określona reklama zmieniła wynik wyborów albo że bez Cambridge Analytica zwyciężyłby inny kandydat.
I paradoksalnie właśnie dlatego historia jest jeszcze ciekawsza. Nie trzeba wierzyć w marketing Cambridge Analytica, żeby uznać Cambridge Analytica za ogromny skandal.
Bo największym problemem nie było to, czy algorytm działał
Załóżmy nawet najbardziej korzystny dla obrońców firmy scenariusz: modele psychograficzne Cambridge Analytica były mocno przereklamowane, reklamy nie wpływały na wyborców bardziej niż zwykły marketing internetowy, a część przechwałek kierownictwa była przede wszystkim metodą zdobywania klientów.
Co to zmienia dla 80 mln ludzi, których informacje zostały pozyskane bez bezpośredniej zgody?
Niewiele.
Jeżeli ktoś nieuprawniony kopiuje milion dokumentów medycznych, fakt, że później okazuje się kiepskim analitykiem, nie sprawia, że przestajemy interesować się kopiowaniem dokumentacji. Cambridge Analytica przez lata przesuwała uwagę na skuteczność swojej technologii, bo właśnie tę skuteczność sprzedawała klientom. Z punktu widzenia prywatności najważniejsza była jednak rzecz znacznie prostsza: skąd wzięliście te dane i czy ludzie wiedzieli, że je macie?
W przypadku milionów osób odpowiedź na drugie pytanie brzmiała: nie.
Czego nauczyła nas Cambridge Analytica?
Pierwsza lekcja jest brutalnie prosta: Twoja prywatność może zależeć od zachowania innych ludzi. Model Facebooka z tamtej epoki pozwalał aplikacji uzyskać informacje o człowieku poprzez aktywność jego znajomego. Użytkownik mógł być ostrożny, a mimo to znaleźć się w gigantycznym zbiorze danych.
Druga lekcja dotyczy skali. Kilkaset tysięcy użytkowników aplikacji nie brzmi imponująco przy miliardowej platformie. Jeśli jednak każdy z nich otwiera dostęp do fragmentu swojej sieci społecznej, kilkaset tysięcy instalacji może przełożyć się na dziesiątki milionów profili.
Trzecia dotyczy danych inferowanych. Informacja nie musi znajdować się bezpośrednio w bazie, żeby przedsiębiorstwo mogło ją posiadać. Algorytm może stworzyć nową informację z dziesiątek niewinnych zachowań. To właśnie dlatego współczesna prywatność dotyczy nie tylko zbierania danych, ale też profilowania.
Czwarta lekcja brzmi: zgoda napisana gdzieś w regulaminie nie zawsze oznacza świadomą decyzję użytkownika. Człowiek robiący krótki test osobowości za kilka dolarów raczej nie analizuje wszystkich przyszłych sposobów, w jakie jego cyfrowe zachowania mogą zostać połączone z rejestrem wyborców i wykorzystane w komercyjnych usługach politycznych.
Piąta dotyczy platform. Facebook przez lata próbował przedstawiać nadużycia deweloperów jako naruszanie zasad przez podmioty trzecie. Tyle że to Facebook zaprojektował API, które dawało aplikacjom tak szerokie możliwości. Odpowiedzialność za bezpieczeństwo platformy nie kończy się na napisaniu regulaminu zabraniającego złych rzeczy.
Szósta lekcja jest szczególnie ważna dla mediów: nie należy mylić udokumentowanego nadużycia danych z nieudowodnionymi teoriami o rezultacie wyborów. Cambridge Analytica nie musi być magiczną machiną kontrolującą demokrację, żeby być jednym z największych skandali związanych z prywatnością w historii social mediów.
23 osoby wystarczyły, żeby problem dotyczył ponad 57 tysięcy Polaków
I chyba właśnie ta liczba najlepiej zamyka całą historię. Nie 87 milionów. Nie pięć miliardów dolarów. Nie Donald Trump, Brexit ani przesłuchanie Zuckerberga.
Dwadzieścia trzy osoby.
Tyle osób z Polski miało bezpośrednio zainstalować aplikację odpowiedzialną za aferę. Potencjalnie dotkniętych polskich kont było ponad 57 tysięcy.
To pokazuje absurd modelu, który przez lata traktowaliśmy jako naturalną cechę internetu. Człowiek zakładał konto w serwisie społecznościowym i godził się, że Facebook będzie coś o nim wiedział. Znacznie mniej oczywiste było to, że później znajomy może zainstalować aplikację, aplikacja pobierze informacje także o nim, dane zostaną skopiowane do zewnętrznej firmy, zewnętrzna firma przekaże je kolejnemu podmiotowi, a kilka lat później użytkownik zobaczy komunikat informujący, że jego informacje mogły znaleźć się w bazie firmy od politycznego mikrotargetowania.
Cambridge Analytica nie pokazała więc, że Facebook potrafi czytać ludziom w myślach. Pokazała coś bardziej przyziemnego i znacznie łatwiejszego do udowodnienia: platforma wiedziała o swoich użytkownikach bardzo dużo, a przez pewien czas zdecydowanie zbyt łatwo pozwalała innym sięgać po tę wiedzę.
Aktualizacja 22.10.2026: META poniosła konsekwencje afery Cambridge Analytica. 25 MILIARDÓW DOLARÓW kary dla Facebooka.